
poteto
@poteto
How I Use Cursor
在 X 上查看更新于 2026-10-04
poteto
@poteto
How I Use Cursor
在 X 上查看
我得坦白一件事。去 @cursor_ai 面试之前,我其实从没真正用过 Cursor。
在 Meta 的时候,Claude Code 正火得一塌糊涂。我甚至自掏腰包,买了每月 200 美元的个人套餐,专门给业余项目用。我喜欢它简单,也喜欢一上手就能高效干活的感觉。真正让我离不开它的,是给它开发自己的一套 skill。这些 skill 几乎能把 cc(Claude Code)变成我想要的任何东西。我甚至开始在它上面开发自己的 agent 编排工具。
现场面试那两天,我一直用 Cursor 做面试项目。当时 Cursor 3 还没发布,所以我用的是 Editor Window。我用 vscode 已经这么多年,大部分快捷键都还在我的上下文窗口里,所以重新用回 IDE 并不太难。不过说实话,头一两个小时我确实很想念命令行。拿鼠标点来点去,简直有点野蛮。但有几件事让我印象特别深。
第一,我当时用惯的 Opus 和 Codex,不知怎么好像变聪明了。还能随时切换模型,在项目的不同部分同时用上这两个模型(Opus 做前端,Codex 做系统层),这一点太惊艳了。面试之前,我就已经在到处夸多模型的对抗式评审,所以能直接在界面里这么做,感觉顺理成章。更棒的是,还能拉起不同模型的子代理,一次对话里就能同时拿到两边的长处。
第二,compaction(上下文压缩)快得离谱。用 cc 的时候,我早就习惯了一次 compaction 要好几分钟,所以总是提心吊胆地盯着上下文和套餐用量。因此 Cursor 的速度让我大吃一惊。快到我基本再也不用去看上下文用了多少。它就是好用。反观 cc,compaction 之后我常觉得模型一下子变得特别笨。
第三,我发现 GUI 能比 TUI(终端里的文本界面)多给出很多东西。直接在 Cursor 的浏览器里打开自己的应用,再用 Design Mode 改设计,感觉很直观。这也让我开始琢磨,专门打造的界面能让 agent 编程高效多少。
三月底入职以后,我主要在做 Cursor 3 的 Agent Window,平时也拿它当主力工具。我仍然觉得 cc 是个很酷的产品,团队也很棒。但我发现,正因为它简单,大家总想在它外面再包一层自己的抽象。在上一份工作里,感觉每周都有人发布一个基于 cc 的新内部编排工具。
@bcherny 经常讲「latent demand」(潜在需求)这个概念:
「做产品有个很老的概念,叫 latent demand……你把产品做得能随便改,足够开放,让大家能把它滥用到别的用途上。然后你看大家怎么滥用,再照着去做。」
说的就是这个!大家不约而同地去做编排工具,正好暴露了 latent demand 在哪:用命令行的时候,编排者就是你这个人。
但我用过的每一种 agent 工作流,重点都放错了。在 GUI 里同时跑好几个命令行工具,完全没抓住要害。我感兴趣的做法,是建立对 agent 的信任。
我以前当过工程经理,很快就意识到,管理 agent 跟组建一支真人工程团队很像。新人入职要有人带,让他们熟悉代码库,也熟悉活是怎么干的。他们入职时就已经预训练好了,身上带着从过往经历里学来的技能。随便举几个:怎么调试,怎么写高质量的代码和测试,怎么沟通。
而 agent 就像永远失忆、永远犯傻的新人。你跟它们说过的话,它们记不住,也从来没真正学会过什么新东西。但我们可以给它们配上 rule、skill、工具和长期记忆,大致补上这一块。它们能干,但也蠢,而且非常好教。在我看来,它们的每一种失败模式都是机会,让我把自己懂的那套深入、严谨的工程做法全教给它们。
因为一旦没有严谨,agent 就会一味讨好你,不择手段地写出你要的代码。而且好家伙,它能写,也真会写,一写就是一大堆。简单粗暴地并行,只会让它们更快地产出 slop(粗制滥造的代码)。
我越来越确信,并行编排很多 agent,价值在于钻深,不在于铺广。你要在一个或少数几个问题上钻得更深,才能把拿到好结果的机会拉到最大:
- N 选一的赛跑,挑出最好的解法
- 对抗式评审
- 让多个 agent 一起尝试复现报上来的问题
- 不同类型的活交给不同的模型
借 @mattpocockuk 的话说,「代码并不便宜」。
这比让一堆 agent 分头处理 10 个不同的问题、自己在它们之间来回切换上下文要强。瓶颈还是在我身上。我得记住每个 agent 在干什么,还得把这些都装在自己的上下文窗口里。我觉得以后会有更好的界面来解决这个问题。
还有信任这个因素。信任越多,你在视角的梯子上就能爬得越高。信任很少的时候,你只能对每一个 agent 都事无巨细地盯着。能放手了,你就能把更多事交出去。这跟管人一模一样!
原帖:@poteto
我确实觉得,agent 编排是能做出成效的。但我们得按深度优先的路子来。
我把 pstack 开源了。这是我个人的一套 skill 和工程原则,我每天开发 @cursor_ai 都在用。这些 skill 的早期版本,是我在业余项目里开始写的,之后一直在打磨。
在这里获取:https://cursor.com/marketplace/cursor/pstack
/add-plugin pstack这些 skill 已经是 Cursor 团队最常用的一批了,所以能分享给大家,我很兴奋。
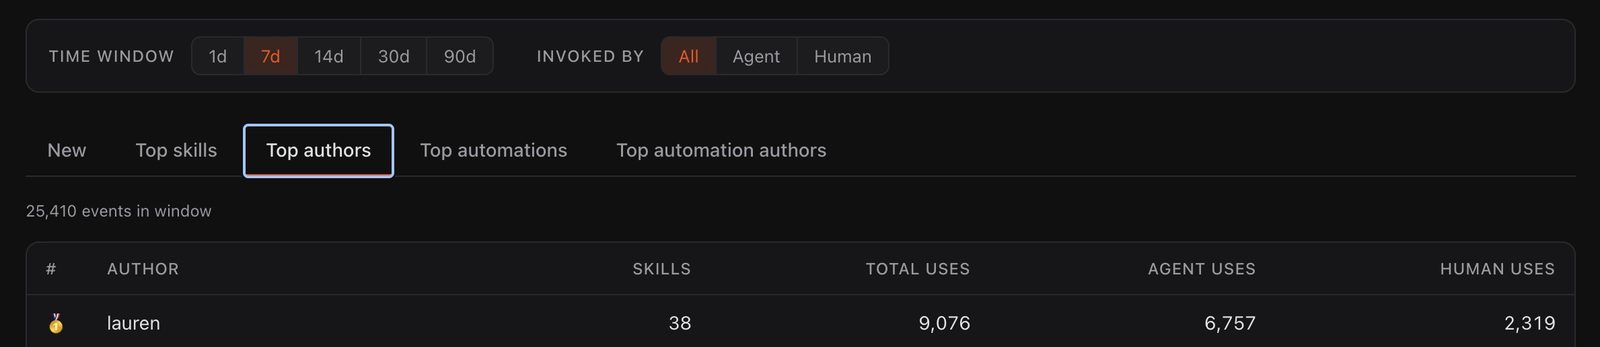
Cursor 公司内部的排行榜。这周我的 skill 用了 9k 次!
pstack 用多个模型,教 agent 变得更严谨。我把自己观察到的所有失败模式,都做成了 skill。这个插件的核心是 /poteto-mode。它是一个高阶 skill,会针对手头的任务,给 agent 挑一份该照着走的 playbook。目标不是把代码行数堆到最多,恰恰相反,是用最少的代码做出最大的成效。
要做到严谨,就要像有经验的工程师那样处理问题。比如调试,一个很好的办法是对问题空间做二分查找。你先对可能出了什么事提几个假设,再有条理地逐个排除,直到越来越接近真正的根因。如果问题难以复现,可以想办法人为地逼这个 bug 出现。也可以加插桩或 console 日志,在程序运行时查看它的状态。
这些步骤合起来就是一份 playbook,agent 可以照着它彻底排查问题,而不是瞎猜。你要是由着它们,它们很乐意瞎猜。pstack 自带很多 skill 和 playbook,让你用同样的严谨程度做软件工程。我目前有这些方面的 playbook:
需要严谨的时候,就在提示词前面加上 /poteto-mode。例如:
/poteto-mode this pr has a subtle bug where the scroll drifts every 750ms even when idle. repro first, then fix and verify./poteto-mode a big list takes a second or two to load even though we virtualize. run a cpu trace and tell me why./poteto-mode build a small feature behind a feature flag. verify it really works./poteto-mode build two prototypes of the markdown renderer so we can compare. spawn an agent for each./poteto-mode open source these skills as a plugin. nothing internal leaks, work in a temp dir, show me the dependency graph first./poteto-mode i'm going to bed. land the stack even if ci flakes. i want everything merged by morning./poteto-mode the row spacing is too tall when this flag is on. the second image is correct. repro and fix until it matches.其他 skill 你也可以按需调用:
最后,你还可以用 /automate-me 做一个自己的 mode skill。它会挖掘你最近的对话记录,按你的工作方式起草一个 your-mode skill,底层走的仍然是 pstack。
pstack 能用在任何 agent 编程工具里,但在 Cursor 这类多模型工具里效果尤其好。很多 skill 都用多模型工作流,利用每个模型各自独特的长处和短处。这也是 agent 编排,只不过走的是深度优先,而不是广度优先。
用 agent 干活,瓶颈在验证。它们能很快写出大量代码。可要确认这些代码全都正确,难度极高。等你能做到这一步,真正的 agent 并行才有可能实现,就像软件行业的黑灯工厂那样。
但首先,我们得往深里走,做到严谨。我觉得,要走到那一步,靠的是把信任一点点调高。
试试 pstack,告诉我你的想法。
有了这些 skill,我写代码时更有底气。但现在所有代码都由 agent 来写,维护代码成了一场噩梦。bug、性能问题、功能需求,照样得花时间一个个处理。而且现在要处理的东西多太多了!
我在 Cursor 内部大量使用 Cursor automations。它们是 cloud agent,可以定时运行,也可以由事件触发,比如 Slack 频道里来了新消息。我的机器人 Benny 就是一个例子。我给他装上了和 pstack 里一样的 skill。
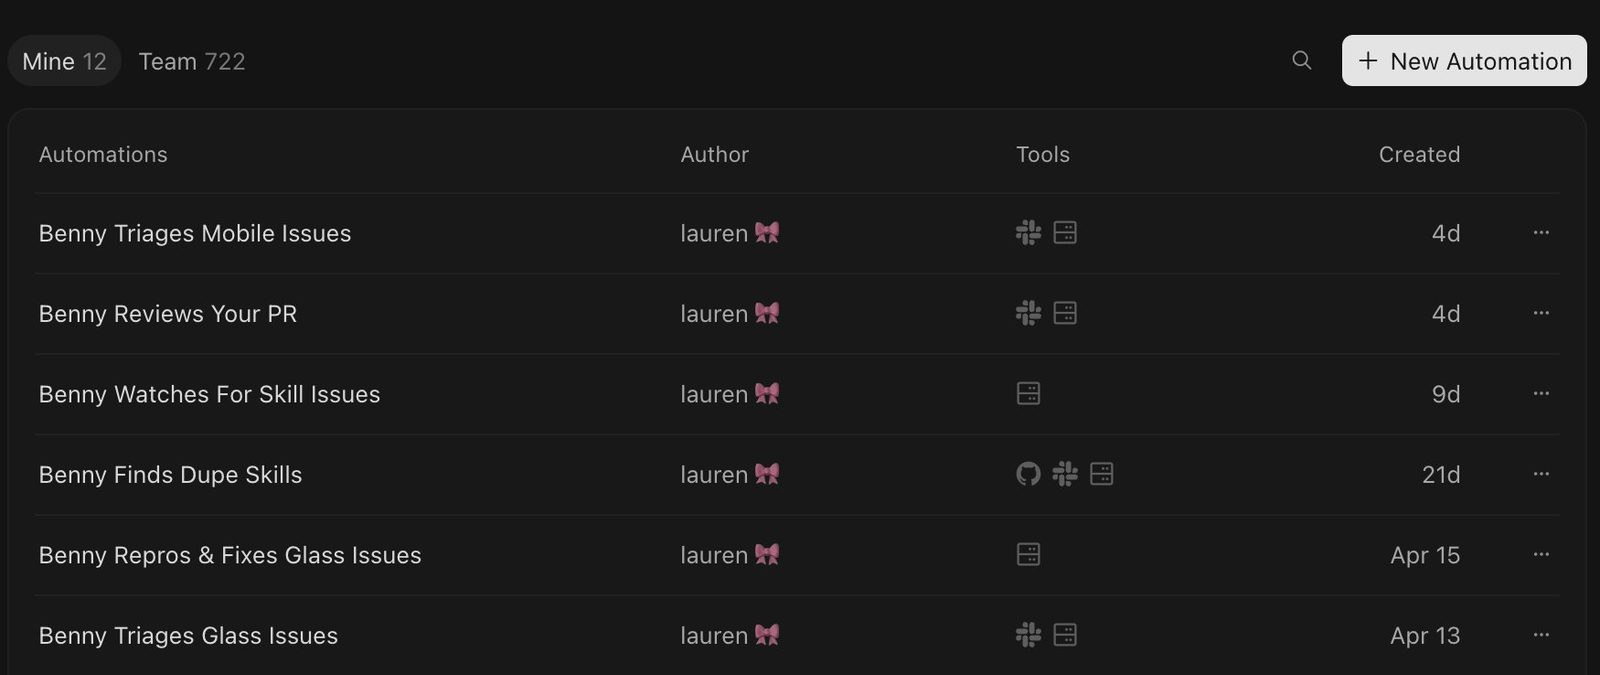
Benny 的各种化身
Benny 还在开发中,但我的设想是,把软件维护流程尽可能多地自动化。思路是这样的:既然我们已经有信心靠 pstack 把大多数问题「一次搞定」,而且相当确定 PR 质量很高,那反馈这一环肯定也能自动化。
这座工厂的第一道工序是 triage(分诊),也就是向员工收集 bug 报告的相关信息。我们自己大量 dogfood(自家产品自己先用)Cursor,所以每个候选发布版都会收到很多员工反馈。Benny 看得懂图片和视频附件,会用 pstack 的 skill 探索代码库。如果复现步骤不清楚,他还会找报告人聊,问清楚怎么复现。
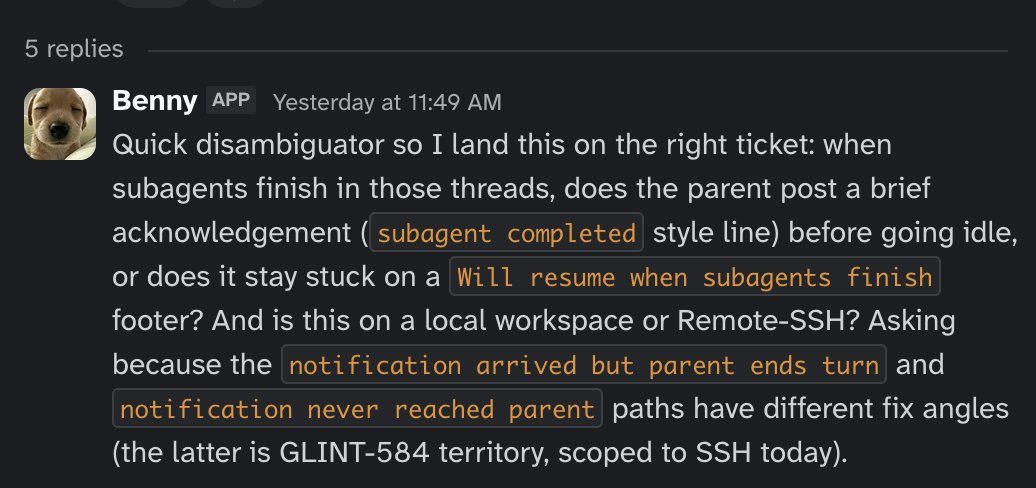
Benny 在追问更多信息
这是 bug 报告流程里很重要的一环。没有清楚的复现步骤,也不知道到底哪里坏了,agent 就只能瞎猜解法。我们得让它们清楚地知道,问题到底坏在哪里、是怎么坏的。
triage 完成后,Benny 会建一张工单,写上他的 finding(调查结果)。他会看代码,翻 git 历史找最近引入的回归,在 Slack 里找关于同一个 bug 的其他消息,甚至去 Notion 查设计和产品上的决策,看这个功能本来该怎么工作。这到底是 bug,还是本来就设计成这样?
工单建好后,另一个 Benny 机器人会接手,用的是我做的另一个 skill,叫 /orchestrate。
推出 /orchestrate。这个 skill 用 Cursor SDK 递归地拉起 agent,帮你攻克最有野心的任务。
我们已经用它:
- 对内部 skill 做 autoresearch(让 agent 自动跑实验、反复改进),token 用量降低 20%,评测成绩还提高了
- 把内部后端的冷启动时间缩短了 80%
原帖:@cursor_ai
首先,他会直接操控电脑,试着复现问题。Cursor 的 Cloud Agents 能在云端运行 Cursor 本身,在那里操作桌面、点击界面、发送键盘输入。背后用的是我做的另外一些 skill。它们用 CDP 这类协议或其他等效手段,以编程方式控制我们的产品。
这样我们就能证明,这份 bug 报告到底能不能复现。如果能稳定复现,他接着就会尝试修复。如果是性能问题,Benny 可以在修复前后各抓一份 CPU trace 和堆快照。子规划 agent 会再拉起更多 worker,用 pstack 的 skill 验证修复,并对照工单检查问题是不是真的修好了。
这一次运行还会拉起更多 worker,录下修复前后的视频。最后由一个 worker 开 PR 提交评审,描述里附上视频。
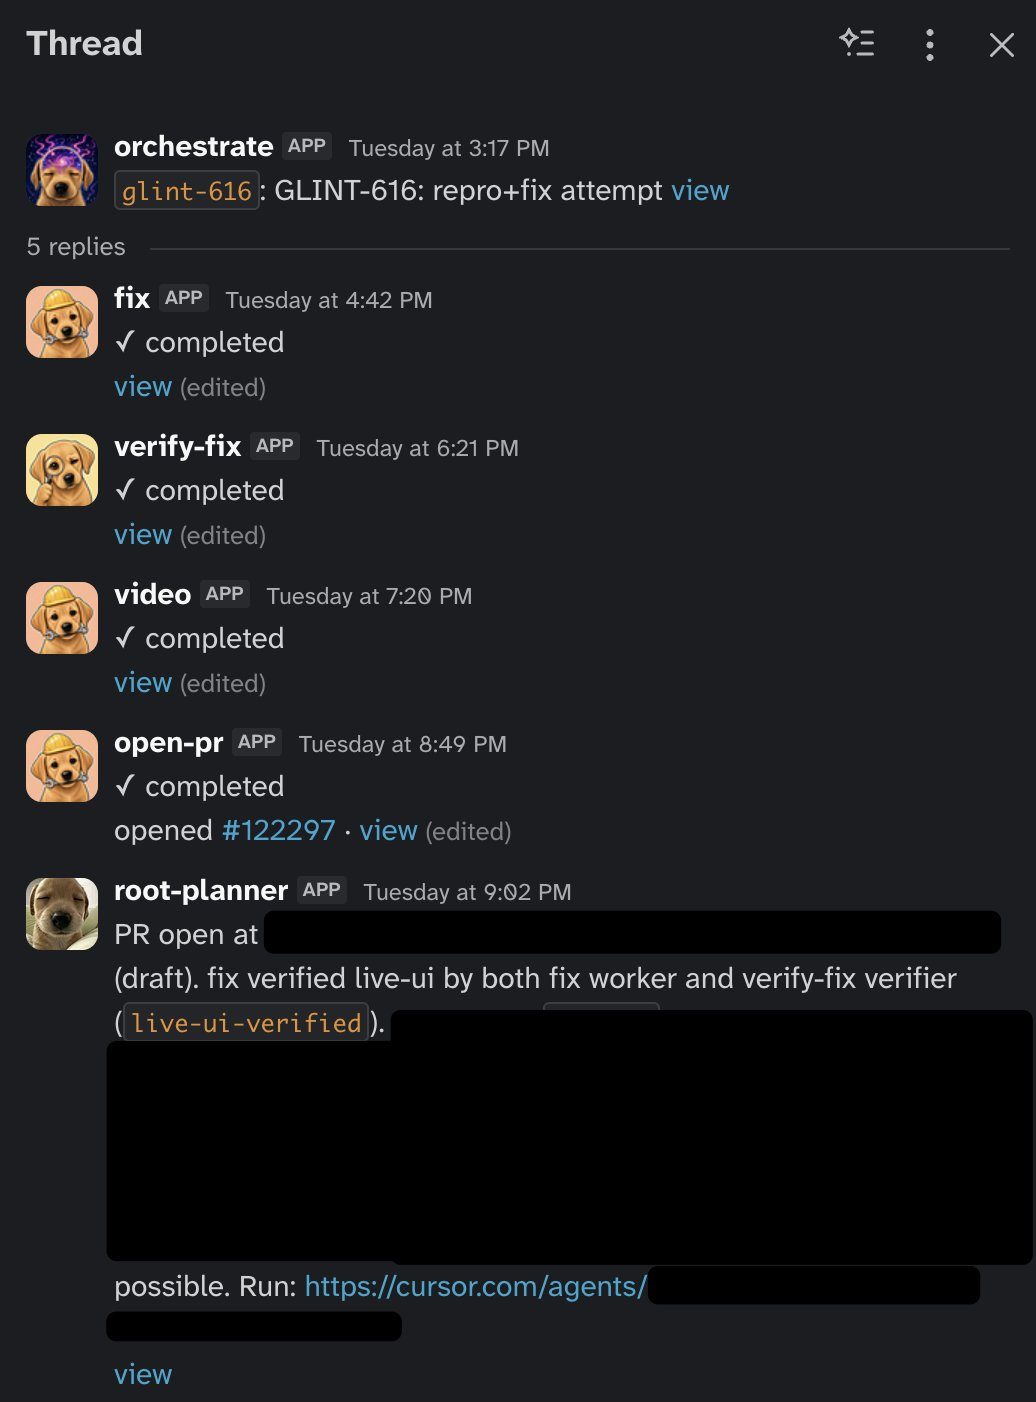
最近一次运行,问题成功复现并修好了
这一切都还在开发中,要做的事还多得很。但想到有一支 agent 团队,能在我睡觉或忙别的事时帮我有把握地修 bug,我就很兴奋。让代码评审跟得上规模,是另一个大方向。我觉得 Cursor 接下来会推出一些很酷的功能来帮忙。
但要搭建你自己的软件工厂,关键在于信任。除非你能放心让一个 agent 从头到尾负责一个问题,包括验证在内,否则你没法把流程自动化。pstack 这类插件能让 agent 有更深的工程功底。用它们把信任调高,你就可以开始攻克更有野心的问题。对还信不过的 agent 搞并行,是在大把浪费 token,还会往代码库里塞进更多 slop。
感谢阅读!
顺便提醒一句,如果你在意花费:同时用多个 agent,尤其是 frontier(最前沿的那一档)模型,会烧掉大量昂贵的 token。
我希望以后的 Composer 能改变这一点。又快又便宜,还很强